大数据-2 部署Java/Hadoop环境并集群分发/免密
单机部署,java,hadoop,网上已经有太多的操作文章,这里也做一下记录,方便以后自己查阅。要注意的是,这里的环境是集群部署,也就是多台机器都要部署java/hadoop。慵懒的方式就在操作2遍,但是我们可以使用linux的一下技巧,比如编写集群分发脚本xsync,来实现,在hadoop112上部署环境修改配置,然后同步到hadpp113,hadp114。
下面我们就开始进行操作:
1) hadoop102安装JDK
1)卸载现有JDK
注意:安装JDK前,一定确保提前删除了虚拟机自带的JDK。
2)用传输工具(Termius/Xshell)将JDK导入到opt目录下面的software文件夹下面
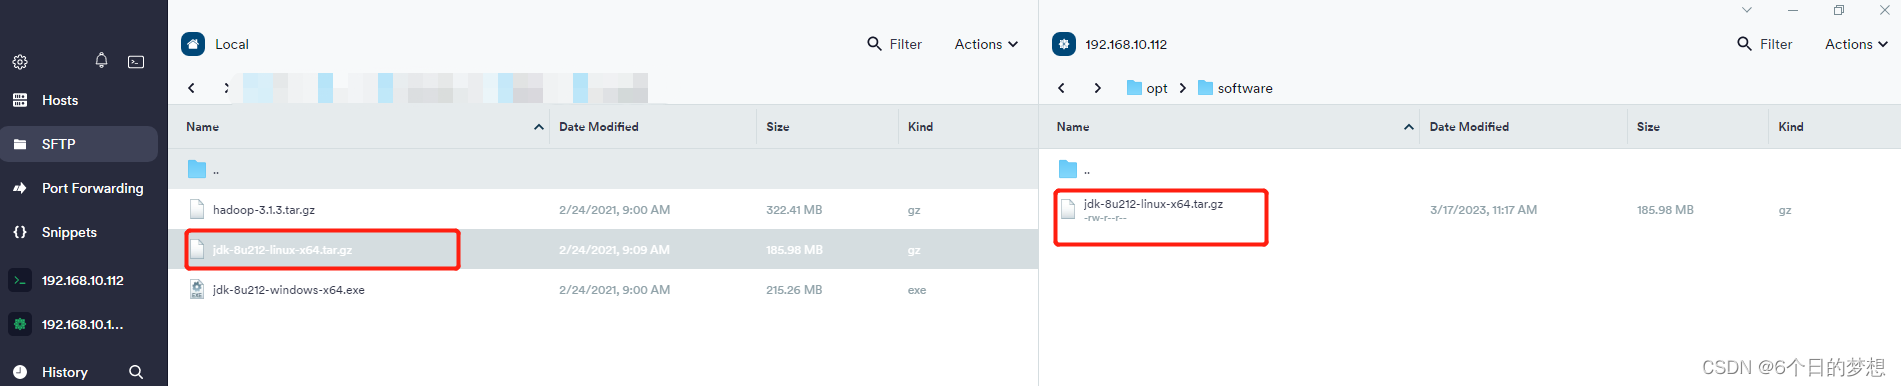
3)在Linux系统下的opt目录中查看软件包是否导入成功
ls /opt/software/
看到如下结果:
jdk-8u212-linux-x64.tar.gz
4)解压JDK到/opt/module目录下
tar -zxvf jdk-8u212-linux-x64.tar.gz -C /opt/module/
5)配置JDK环境变量
(1)新建/etc/profile.d/my_env.sh文件
sudo vim /etc/profile.d/my_env.sh
添加如下内容
#JAVA_HOME
export JAVA_HOME=/opt/module/jdk1.8.0_212
export PATH=$PATH:$JAVA_HOME/bin
(2)保存后退出
:wq
(3)source一下/etc/profile文件,让新的环境变量PATH生效
source /etc/profile
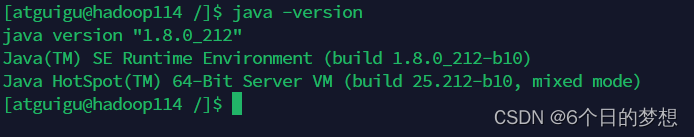
6)测试JDK是否安装成功
java -version
如果能看到以下结果,则代表Java安装成功。
java version "1.8.0_212" 没出来,可以重启试下。
2) 在hadoop112安装Hadoop
Hadoop下载地址:https://archive.apache.org/dist/hadoop/common/hadoop-3.1.3/
可以选择对应的版本
同样讲文件导入到服务器
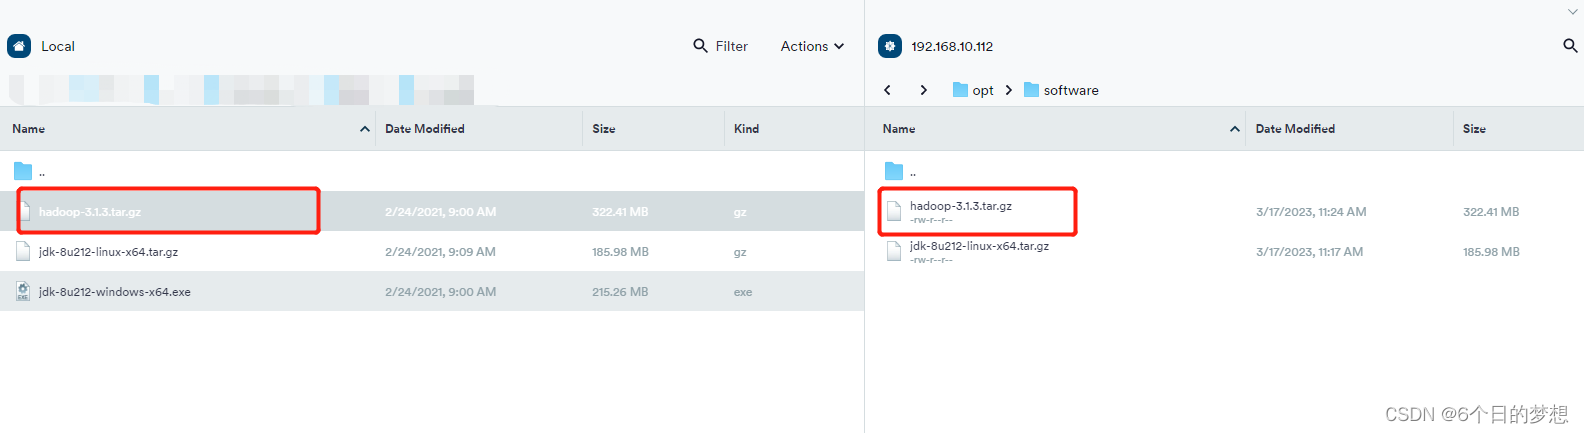 2)进入到Hadoop安装包路径下
cd /opt/software/
3)解压安装文件到/opt/module下面
tar -zxvf hadoop-3.1.3.tar.gz -C /opt/module/
4)查看是否解压成功
ls /opt/module/
hadoop-3.1.3
5)将Hadoop添加到环境变量
(1)获取Hadoop安装路径
pwd
/opt/module/hadoop-3.1.3
(2)打开/etc/profile.d/my_env.sh文件
sudo vim /etc/profile.d/my_env.sh
- 在my_env.sh文件末尾添加如下内容:(shift+g)
#HADOOP_HOME
export HADOOP_HOME=/opt/module/hadoop-3.1.3
export PATH=$PATH:$HADOOP_HOME/bin
export PATH=$PATH:$HADOOP_HOME/sbin
- 保存并退出: :wq
(3)让修改后的文件生效
source /etc/profile
6)测试是否安装成功
hadoop version
Hadoop 3.1.3
7)重启(如果Hadoop命令不能用再重启虚拟机)
sudo reboot
3 )Hadoop目录结构
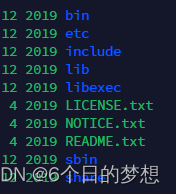
(1)bin目录:存放对Hadoop相关服务(hdfs,yarn,mapred)进行操作的脚本
(2)etc目录:Hadoop的配置文件目录,存放Hadoop的配置文件
(3)lib目录:存放Hadoop的本地库(对数据进行压缩解压缩功能)
(4)sbin目录:存放启动或停止Hadoop相关服务的脚本
(5)share目录:存放Hadoop的依赖jar包、文档、和官方案例
4) Hadoop知识点
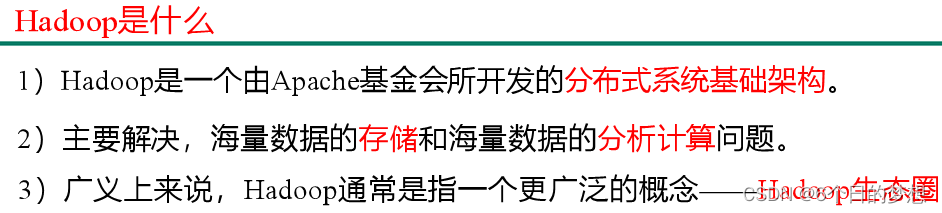
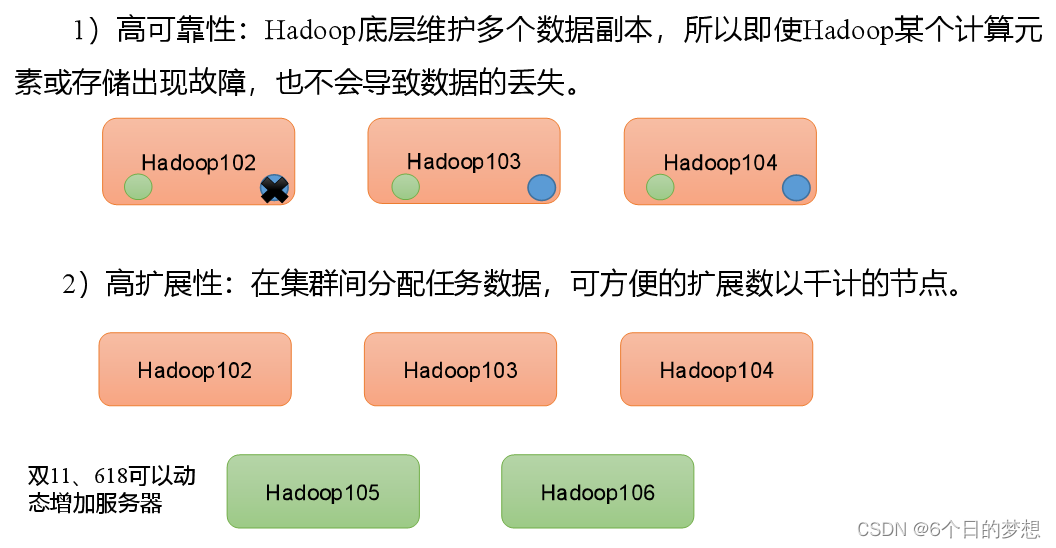
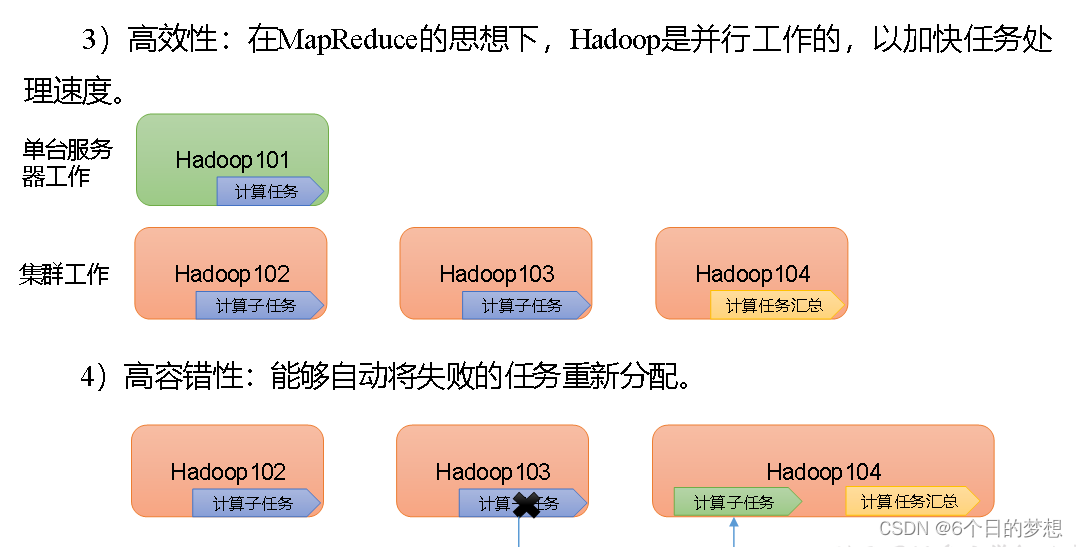
优势:
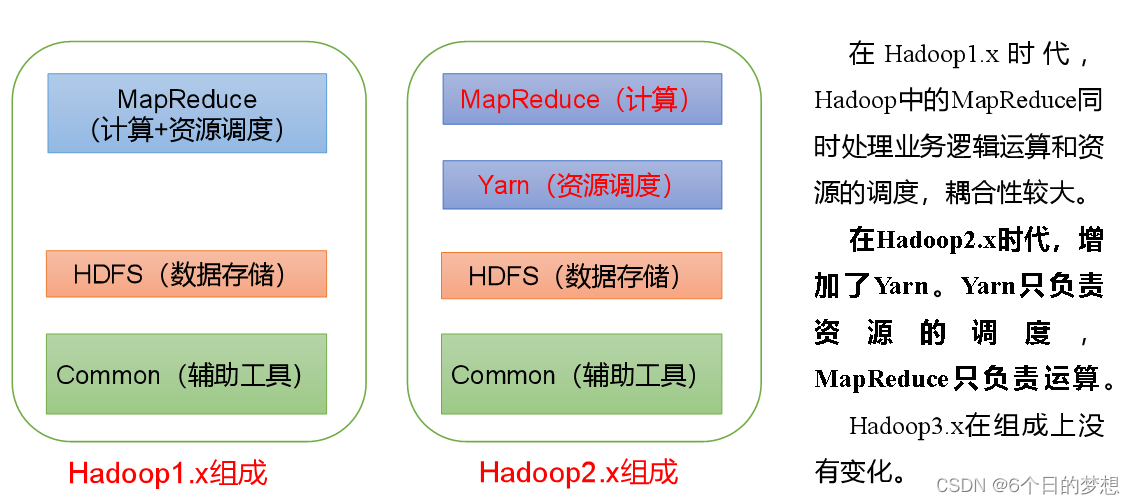
组成:
Hadoop Distributed File System,简称HDFS,是一个分布式文件系统。



Yet Another Resource Negotiator简称YARN ,另一种资源协调者,是Hadoop的资源管理器。
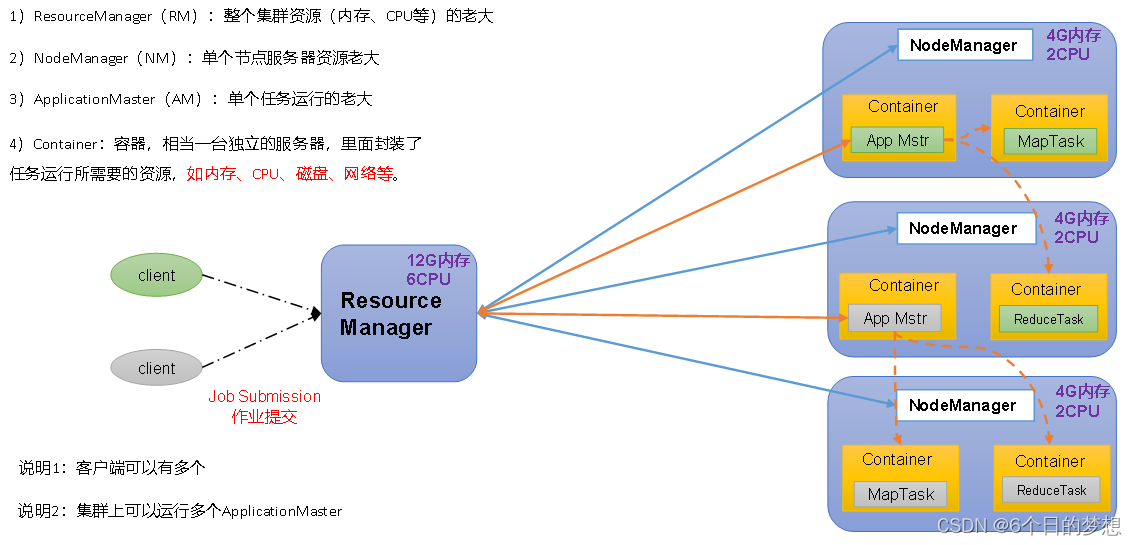
说明3 :每个NodeManager上可以有多个Container.
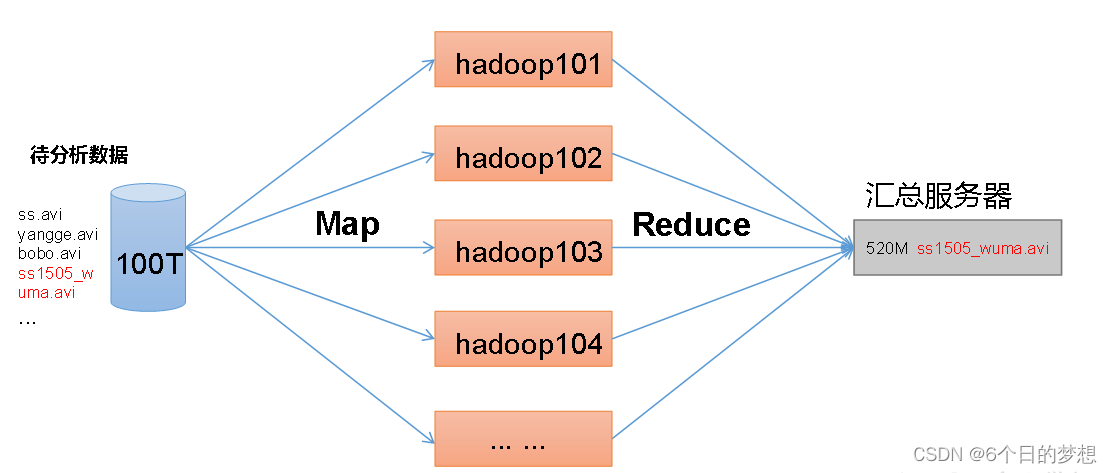
MapReduce将计算过程分为两个阶段:Map和Reduce
1)Map阶段并行处理输入数据
2)Reduce阶段对Map结果进行汇总
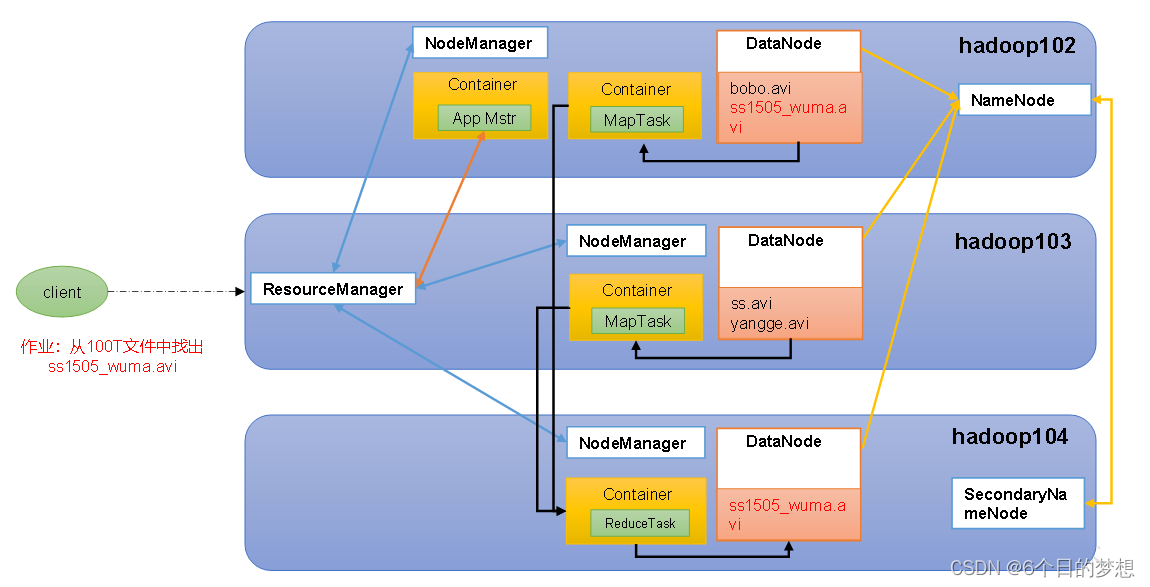
HDFS、YARN、MapReduce三者关系
4) Hadoop运行模式
本地模式、伪分布式模式以及完全分布式模式。
这里3台机器独立,采用完成分布式模式.
下面配置完成分布式模式:
分析:
1)准备3台客户机(关闭防火墙、静态IP、主机名称)
2)安装JDK
3)配置环境变量
4)安装Hadoop
5)配置环境变量
6)配置集群
7)单点启动
8)配置ssh
9)群起并测试集群
重要: 编写集群分发脚本xsync
1)scp(secure copy)安全拷贝
(1)scp定义 (jenkins中自动化打包也有用到这个命令)
scp可以实现服务器与服务器之间的数据拷贝。(from server1 to server2)
(2)基本语法
scp -r $pdir/$fname $user@$host:$pdir/$fname
命令 递归 要拷贝的文件路径/名称 目的地用户@主机:目的地路径/名称
(3)案例实操
- 前提:在hadoop102、hadoop103、hadoop104都已经创建好的/opt/module、 /opt/software两个目录,并且已经把这两个目录修改为atguigu:atguigu
[hadoop112 ~]$ sudo chown atguigu:atguigu -R /opt/module
(a)在hadoop112上,将hadoop112中/opt/module/jdk1.8.0_212目录拷贝到hadoop113上。
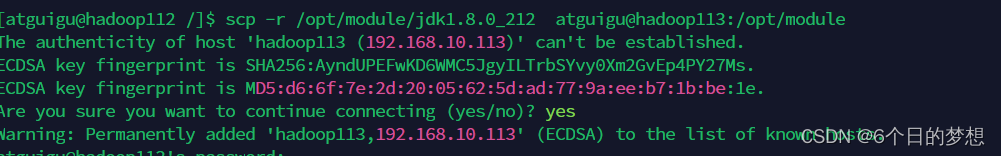
[atguigu@hadoop112 ~]$ scp -r /opt/module/jdk1.8.0_212 atguigu@hadoop113:/opt/module
(b)在hadoop113上,将hadoop112中/opt/module/hadoop-3.1.3目录拷贝到hadoop113上。
[atguigu@hadoop103 ~]$ scp -r atguigu@hadoop102:/opt/module/hadoop-3.1.3 /opt/module/
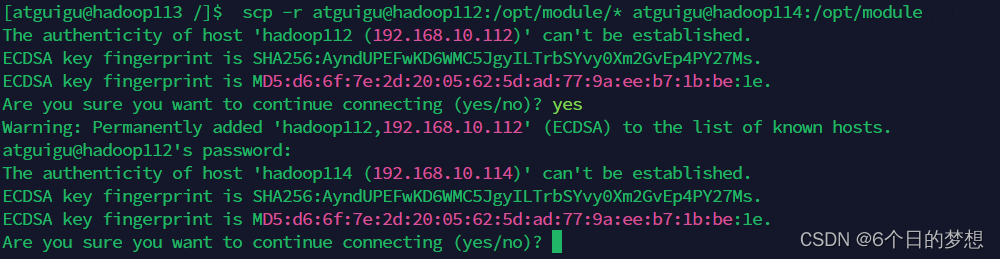
(c)在hadoop113上操作,将hadoop112中/opt/module目录下所有目录拷贝到hadoop114上。
[atguigu@hadoop103 opt]$ scp -r atguigu@hadoop102:/opt/module/* atguigu@hadoop104:/opt/module
2)rsync远程同步工具
rsync主要用于备份和镜像。具有速度快、避免复制相同内容和支持符号链接的优点。
rsync和scp区别:用rsync做文件的复制要比scp的速度快,rsync只对差异文件做更新。scp是把所有文件都复制过去。
(1)基本语法
rsync -av $pdir/$fname $user@$host:$pdir/$fname
命令 选项参数 要拷贝的文件路径/名称 目的地用户@主机:目的地路径/名称
选项参数说明
| 选项 | 功能 |
| -a | 归档拷贝 |
| -v | 显示复制过程 |
(2)案例实操
(a)删除hadoop113中/opt/module/hadoop-3.1.3/wcinput
[hadoop113 hadoop-3.1.3]$ rm -rf wcinput/
(b)同步hadoop112中的/opt/module/hadoop-3.1.3到hadoop113
[atguigu@hadoop102 module]$ rsync -av hadoop-3.1.3/ atguigu@hadoop103:/opt/module/hadoop-3.1.3/

3)xsync集群分发脚本
(1)需求:循环复制文件到所有节点的相同目录下
(2)需求分析:
(a)rsync命令原始拷贝:
rsync -av /opt/module hadoop113:/opt/
(b)期望脚本:
xsync要同步的文件名称
(c)期望脚本在任何路径都能使用(脚本放在声明了全局环境变量的路径)
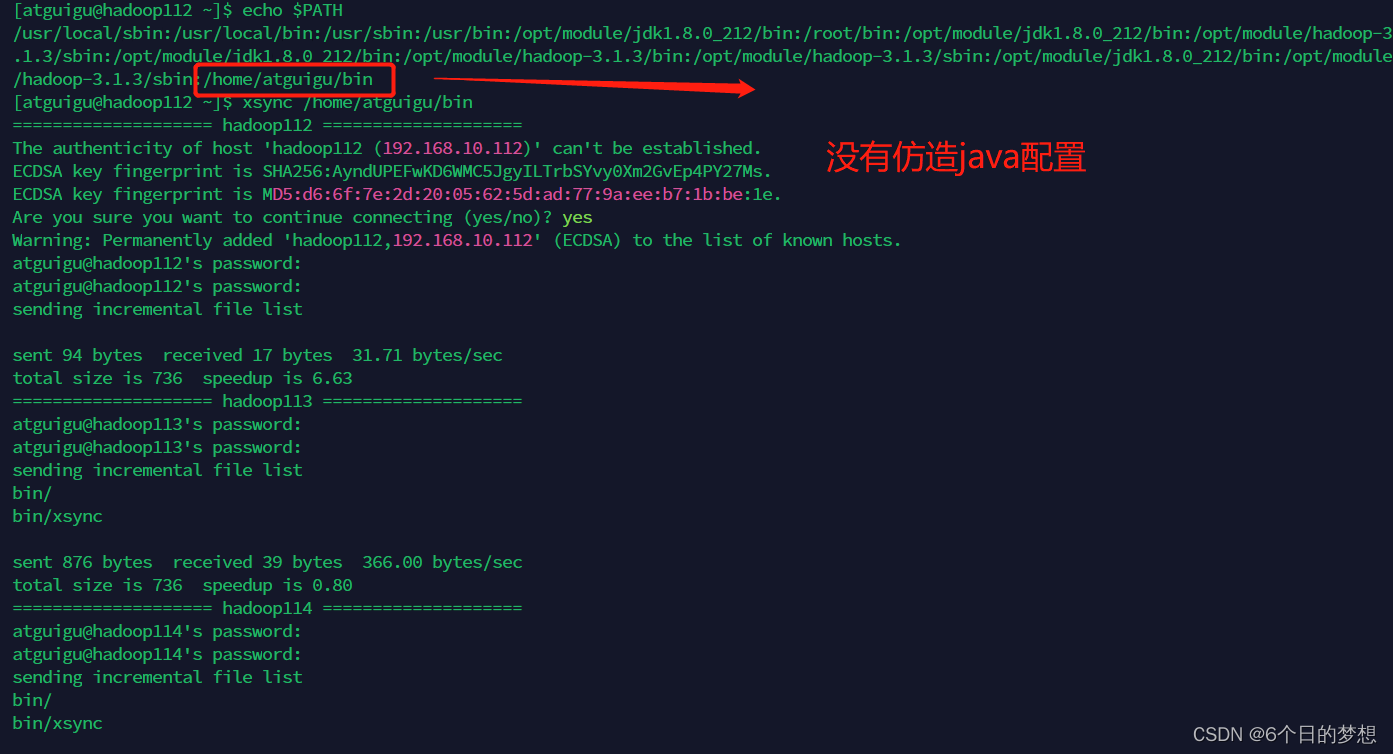
[hadoop112 ~]$ echo $PATH
/usr/local/bin:/usr/bin:/usr/local/sbin:/usr/sbin:/home/atguigu/.local/bin:/home/atguigu/bin:/opt/module/jdk1.8.0_212/bin
(3)脚本实现
(a)在/home/atguigu/bin目录下创建xsync文件
[atguigu@hadoop112 opt]$ cd /home/atguigu
[atguigu@hadoop112 ~]$ mkdir bin
[atguigu@hadoop112 ~]$ cd bin
[atguigu@hadoop112 bin]$ vim xsync
在该文件中编写如下代码
#!/bin/bash
#1. 判断参数个数
if [ $# -lt 1 ]
then
echo Not Enough Arguement!
exit;
fi
#2. 遍历集群所有机器
for host in hadoop112 hadoop113 hadoop114
do
echo ==================== $host ====================
#3. 遍历所有目录,挨个发送
for file in $@
do
#4. 判断文件是否存在
if [ -e $file ]
then
#5. 获取父目录
pdir=$(cd -P $(dirname $file); pwd)
#6. 获取当前文件的名称
fname=$(basename $file)
ssh $host "mkdir -p $pdir"
rsync -av $pdir/$fname $host:$pdir
else
echo $file does not exists!
fi
done
done
(b)修改脚本 xsync 具有执行权限
[atguigu@hadoop112 bin]$ chmod +x xsync
(c)测试脚本
[atguigu@hadoop112 ~]$ xsync /home/atguigu/bin
(d)将脚本复制到/bin中,以便全局调用
[atguigu@hadoop112 bin]$ sudo cp xsync /bin/
(e)同步环境变量配置(root所有者)
[atguigu@hadoop112 ~]$ sudo ./bin/xsync /etc/profile.d/my_env.sh
注意:如果用了sudo,那么xsync一定要给它的路径补全。
让环境变量生效
[atguigu@hadoop113 bin]$ source /etc/profile
[atguigu@hadoop114 opt]$ source /etc/profile
4) SSH无密登录配置
配置ssh
(1)基本语法
ssh另一台电脑的IP地址
(2)ssh连接时出现Host key verification failed的解决方法
[atguigu@hadoop112 ~]$ ssh hadoop113
- 如果出现如下内容
Are you sure you want to continue connecting (yes/no)?
- 输入yes,并回车
(3)退回到hadoop112
[atguigu@hadoop113 ~]$ exit
无密钥配置
(2)生成公钥和私钥
[atguigu@hadoop112 .ssh]$ pwd
/home/atguigu/.ssh
[atguigu@hadoop112 .ssh]$ ssh-keygen -t rsa
然后敲(三个回车),就会生成两个文件id_rsa(私钥)、id_rsa.pub(公钥)
(3)将公钥拷贝到要免密登录的目标机器上
[atguigu@hadoop112 .ssh]$ ssh-copy-id hadoop112
[atguigu@hadoop112 .ssh]$ ssh-copy-id hadoop113
[atguigu@hadoop112 .ssh]$ ssh-copy-id hadoop114
注意:
还需要在hadoop113上采用atguigu账号配置一下无密登录到hadoop112、hadoop113、hadoop114服务器上。
还需要在hadoop114上采用atguigu账号配置一下无密登录到hadoop112、hadoop113、hadoop114服务器上。
还需要在hadoop112上采用root账号,配置一下无密登录到hadoop112、hadoop113、hadoop114;
.ssh文件夹下(~/.ssh)的文件功能解释
| known_hosts | 记录ssh访问过计算机的公钥(public key) |
| id_rsa | 生成的私钥 |
| id_rsa.pub | 生成的公钥 |
| authorized_keys | 存放授权过的无密登录服务器公钥 |
检查hadoop112 访问hadoop113,hadoop114不在需要输入密码
hadoop1134j/hadoop11ava版本也查出来了